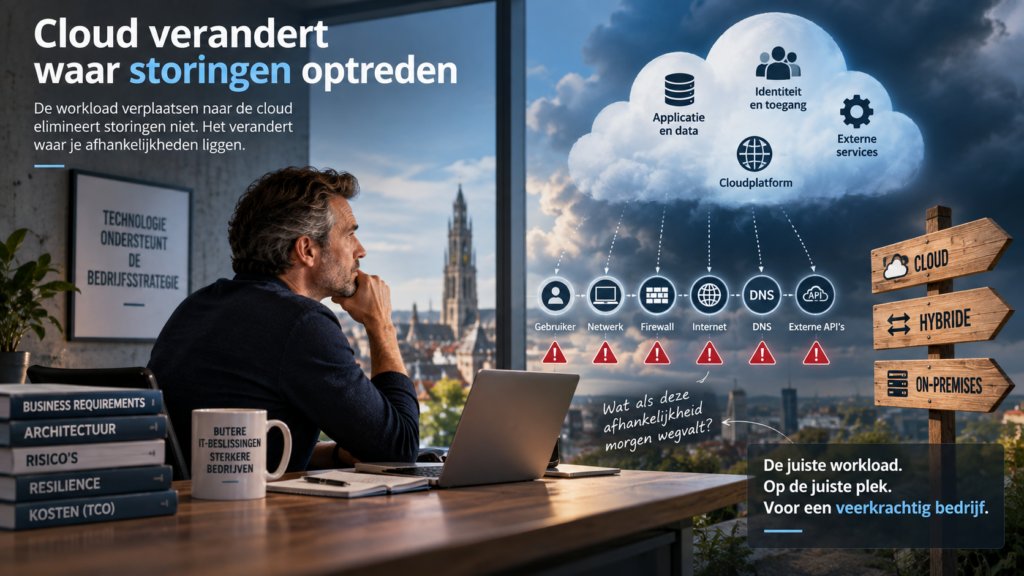
Cloud verandert waar storingen optreden
Een server die uitvalt, zie je meestal vrij snel. Een defecte disk, een stroomprobleem, een kapotte netwerkkaart of een virtualisatiehost die niet meer reageert. Je kent de componenten en je weet waar je moet zoeken.
Verplaats diezelfde workload naar de cloud en het storingsbeeld verandert.
De server staat niet meer in de serverruimte. De infrastructuur wordt beheerd door een cloudprovider. Toch kan de applicatie nog altijd onbeschikbaar zijn. Misschien door een probleem met de internetverbinding. Misschien door een afhankelijkheid van authenticatie, DNS, een API, een cloudservice of een andere externe component.
De workload naar de cloud verplaatsen elimineert storingen niet. Het verandert waar je afhankelijkheden liggen.
Dat is voor mij een belangrijk uitgangspunt bij infrastructuurarchitectuur.
Cloud heeft een belangrijke plaats in moderne IT
Ik gebruik cloudservices wanneer ze vanuit zakelijk oogpunt logisch zijn.
Cloud kan bijzonder interessant zijn voor workloads die behoefte hebben aan elastische capaciteit, wereldwijde distributie, tijdelijke rekenkracht of specifieke managed services. Microsoft beschrijft bijvoorbeeld expliciet dat cloudarchitecturen rekening moeten houden met betrouwbaarheid, beveiliging, kosten, operationele werking en prestaties.
Ook voor kleine en middelgrote bedrijven kan cloud een praktische oplossing zijn.
Je hoeft bijvoorbeeld geen eigen infrastructuur te bouwen voor een workload die slechts tijdelijk veel capaciteit nodig heeft. Een organisatie kan bepaalde diensten als SaaS gebruiken en daardoor zelf minder infrastructuur moeten beheren.
Mijn bezwaar ontstaat wanneer cloud een uitgangspunt wordt voordat de workload en de bedrijfsvereisten zijn onderzocht.
Een cloudomgeving heeft nog altijd afhankelijkheden
Een van de eerste vragen die ik bij een architectuur stel is:
Wat gebeurt er als deze afhankelijkheid morgen wegvalt?
Dat is een eenvoudige vraag, maar het antwoord kan verrassend complex worden.
Microsoft adviseert bij failure-mode analysis expliciet om afhankelijkheden van een workload in kaart te brengen. Daarbij gaat het zowel om interne componenten als externe afhankelijkheden, zoals authenticatie en netwerkverbindingen.
Stel dat een bedrijf een belangrijke applicatie volledig naar de cloud verhuist.
Op papier lijkt de architectuur eenvoudig:
Gebruiker → internet → cloudapplicatie
In werkelijkheid kan daar veel meer achter zitten:
Gebruiker → lokale netwerkvoorziening → firewall → internetverbinding → DNS → identity provider → cloudplatform → applicatie → database → externe API
Iedere component kan relevant worden voor de beschikbaarheid van de bedrijfsapplicatie.
De cloudprovider beheert een groot deel van die infrastructuur. Dat betekent echter niet dat de volledige keten onder controle van de provider staat.
Microsoft formuleert dat zelf als een gedeelde verantwoordelijkheid voor betrouwbaarheid. Microsoft beheert de betrouwbaarheid van het Azure-platform, terwijl de klant verantwoordelijk blijft voor het ontwerp en de werking van zijn workload.
Het internet kan plots een bedrijfskritische afhankelijkheid worden
Dit zie ik als een van de belangrijkste architectuurvragen voor kmo’s.
Een lokale applicatie kan bij een internetstoring soms gewoon blijven functioneren.
De medewerkers zitten op kantoor. De servers staan lokaal. De lokale DNS werkt. Authenticatie werkt. De database is bereikbaar.
De internetverbinding valt weg.
Vervelend, maar de onderneming kan misschien verder werken.
Verplaats je diezelfde applicatie naar een externe cloudomgeving, dan verandert de situatie.
De internetverbinding wordt onderdeel van de toegangsweg naar de applicatie.
Daarmee kan een verbinding die vroeger vooral nodig was voor e-mail, web browsing en externe communicatie plots een infrastructuurcomponent worden waarvan een bedrijfskritische workload afhankelijk is.
Microsoft wijst er bij cloudarchitecturen eveneens op dat netwerkcondities tussen client en server kunnen variëren en dat internetcommunicatie tijdelijke verbindingsproblemen kan veroorzaken.
Daarom kijk ik bij een cloudarchitectuur niet alleen naar de beschikbaarheid van de cloudservice.
Ik kijk naar de volledige keten.
Een SLA van 99,9% lost het architectuurprobleem niet automatisch op
Een SLA kan nuttige informatie geven over de beschikbaarheidsverplichting van een dienst.
Maar een SLA van een afzonderlijke component vertelt niet automatisch wat de beschikbaarheid van de volledige bedrijfsdienst zal zijn.
Dat komt doordat een workload afhankelijk kan zijn van meerdere componenten.
Denk bijvoorbeeld aan:
- de cloudservice zelf
- identity en authenticatie
- DNS
- internetconnectiviteit
- lokale netwerkcomponenten
- firewalls
- externe API’s
- andere cloudservices
- back-up en recovery
- configuratie en beheer
Een architectuur met meerdere afhankelijkheden vraagt dus om een analyse van de volledige keten.
Dat is ook precies waarom Microsoft bij failure-mode analysis aanbeveelt om afhankelijkheden te documenteren en per kritieke flow te bekijken wat er gebeurt wanneer een component faalt.
Daarom begin ik liever met resilience
Mijn uitgangspunt is eenvoudig:
Eerst bepalen hoe het bedrijf moet blijven functioneren. Daarna bepalen welke technologie daarbij past.
Dat betekent dat ik bij een workload eerst naar de bedrijfsimpact kijk.
Wat gebeurt er wanneer deze applicatie één uur niet beschikbaar is?
Wat gebeurt er na vier uur?
Kan het personeel tijdelijk met een alternatieve werkwijze verder?
Moet de dienst onmiddellijk beschikbaar zijn?
Welke gegevens moeten lokaal beschikbaar blijven?
Wat gebeurt er wanneer de internetverbinding wegvalt?
En welke afhankelijkheden kunnen tijdens een incident nog worden gebruikt?
Pas daarna wordt de vraag interessant waar de workload moet draaien.
Dat kan cloud zijn.
Dat kan on-premises zijn.
Het kan ook een combinatie zijn.
Soms is lokaal gewoon een verdedigbare architectuurkeuze
Voor bepaalde kmo-omgevingen kan lokale infrastructuur een praktische rol blijven spelen.
Een lokale identity service, lokale opslag of een lokale applicatie kan ervoor zorgen dat bepaalde bedrijfsprocessen blijven functioneren wanneer externe connectiviteit tijdelijk wegvalt.
In combinatie met redundante internetverbindingen, gerepliceerde opslag en selectieve cloudservices ontstaat een hybride architectuur waarin iedere component een duidelijke functie heeft.
Dat sluit ook aan bij de manier waarop Microsoft zelf workload placement benadert. Microsoft noemt onder andere latency, bandbreedte, beschikbaarheid, resilience en lokale afhankelijkheden als factoren bij de keuze waar een workload en zijn data worden geplaatst. Sommige workloads kunnen lokaal moeten blijven wanneer ze bijvoorbeeld moeten blijven functioneren bij verlies van externe connectiviteit.
Dat vind ik een veel interessanter uitgangspunt dan de vraag:
“Kunnen we dit naar de cloud brengen?”
De betere vraag is:
“Waar moet deze workload staan om het bedrijfsproces op een verantwoorde manier te ondersteunen?”
Cloud en on-premises kunnen elkaar aanvullen
Ik zie daarom steeds vaker waarde in een bewuste hybride architectuur.
Een bedrijf kan bijvoorbeeld:
- bedrijfskritische lokale diensten lokaal beschikbaar houden
- Microsoft 365 gebruiken voor collaboration en communicatie
- cloud gebruiken voor specifieke applicaties
- back-ups buiten de primaire locatie bewaren
- cloud inzetten voor tijdelijke capaciteit
- redundante internetverbindingen voorzien
- lokale systemen zo ontwerpen dat ze tijdelijk zonder internet kunnen functioneren
Zo krijgt iedere technologie een duidelijke rol.
Dat past ook bij mijn bredere visie op infrastructuur. Technologie moet de bedrijfsstrategie ondersteunen. Performance, security en kosten moeten samen bekeken worden. Een Infrastructure Architect moet daarom ook bedrijfsprocessen en risico’s begrijpen.
De cloud is een hulpmiddel binnen je architectuur
Cloudservices hebben een belangrijke plaats in moderne IT.
Ik gebruik ze graag wanneer ze een concreet probleem oplossen of een duidelijke zakelijke meerwaarde bieden.
Elasticiteit kan waardevol zijn.
Managed services kunnen beheer verminderen.
Wereldwijde beschikbaarheid kan voor bepaalde organisaties noodzakelijk zijn.
Tijdelijke capaciteit kan efficiënter vanuit de cloud worden geleverd.
Maar voor iedere workload dezelfde bestemming kiezen, levert geen architectuur op.
Het levert een standaardkeuze op.
Voor mij begint een goede infrastructuurarchitectuur daarom met de bedrijfsvereisten, de afhankelijkheden en de gevolgen van een storing.
Daarna volgen technologie, locatie en implementatie.
De cloud is een krachtige infrastructuurkeuze. De architectuur bepaalt of die keuze ook past bij het bedrijf.
Mijn belangrijkste vraag blijft daarom:
Als deze afhankelijkheid morgen wegvalt, kan het bedrijf dan nog verder werken?
Als het antwoord “nee” is, kijk ik opnieuw naar de architectuur.
Niet omdat de cloud verkeerd is.
Omdat beschikbaarheid uiteindelijk wordt bepaald door de volledige keten.
Ik ben een Systems Integrator en Infrastructure Architect met meer dan 28 jaar professionele ervaring. Mijn mening is mijn eigen mening en de visie van Peritus Consult, niet de mening van mijn werkgever Lab9 Pro.